
過学習を防ぐ早期終了
AIの初心者
先生、「早期終了」ってどういう意味ですか?なんか難しそうでよくわからないです。

AI専門家
そうだね、少し難しいかもしれないね。簡単に言うと「勉強しすぎると、新しい問題が解けなくなることがあるから、ちょうど良いところで勉強をやめること」だよ。例えば、教科書の問題だけを何度も解いて完璧に覚えたとしても、テストで初めて見る応用問題が解けないことがあるよね?そういうことを防ぐための工夫なんだ。
AIの初心者
なるほど。勉強しすぎると新しい問題に対応できなくなるってことですね。でも、ちょうど良いところってどうやって見つけるんですか?
AI専門家
良い質問だね。練習問題を解く中で、初めて見る問題の正答率が下がり始めたら、そこで勉強をやめるんだ。そうすることで、新しい問題にも対応できるようになるんだよ。
早期終了とは。
人工知能の学習において、『早く終わる』という技があります。これは、学習させすぎると、知っているデータに対しては完璧でも、知らないデータにはうまく対応できなくなるという、いわば『詰め込みすぎ』の状態になるのを防ぐための方法です。通常、人工知能の学習には練習用のデータを使いますが、このデータに対する正答率を練習での誤差といいます。これに対して、練習には使っていない、初めて見るデータに対する正答率をテストでの誤差といいます。学習が進むと、練習での誤差は下がりますが、テストでの誤差は上がることがあります。このテストでの誤差が最も低い時点で学習を止める、というのが『早く終わる』という考え方です。
早期終了とは
機械学習の訓練において、学習しすぎを防ぐための大切な方法として早期終了があります。 機械学習では、たくさんの情報を使って学習を進めますが、学習を進めすぎると、与えられた情報にぴったり合いすぎてしまうことがあります。これは、まるで暗記のように、与えられた情報にだけ詳しくなり、それ以外の情報に対応できなくなる状態です。これを過学習と呼びます。
過学習が起きると、学習に使った情報に対する精度はとても高くなります。しかし、新しい情報に対してはうまく対応できず、精度は下がってしまうのです。これは、学習に使った情報だけに特化しすぎてしまい、色々な情報に対応する能力が失われてしまうからです。
早期終了は、この過学習が起きる前に学習を止めることで、色々な情報に対応できる能力を保つための工夫です。 具体的には、学習を進めながら、学習に使っていない別の情報に対する精度もチェックします。この別の情報を検証データと呼びます。学習が進むにつれて、学習データに対する精度は上がり続けますが、検証データに対する精度はある時点で頭打ちになり、その後は下がっていくことが多いです。早期終了では、検証データに対する精度が最も高くなった時点で学習を止めます。
このように、早期終了を用いることで、過学習を防ぎ、未知の情報に対しても高い精度で対応できる、より汎用的な機械学習モデルを作ることができます。 適切なタイミングで学習を止めることで、学習データのみに特化したモデルになることを防ぎ、新しい情報にも対応できる柔軟性を維持できるのです。これは、限られた情報からより多くのことを学び、将来の予測や判断に役立てるために非常に重要な技術です。
過学習の兆候

機械学習を行う上で、学習を適切な時点で止めることはとても重要です。なぜなら、学習させすぎると「過学習」と呼ばれる状態に陥り、新しいデータに対してうまく対応できなくなってしまうからです。この過学習の兆候を見つけるためには、訓練データとテストデータの両方を使って、モデルの性能を測る必要があります。訓練データとは、モデルに学習させるためのデータのことです。テストデータとは、学習済みモデルの性能を評価するための、学習には使っていないデータのことです。
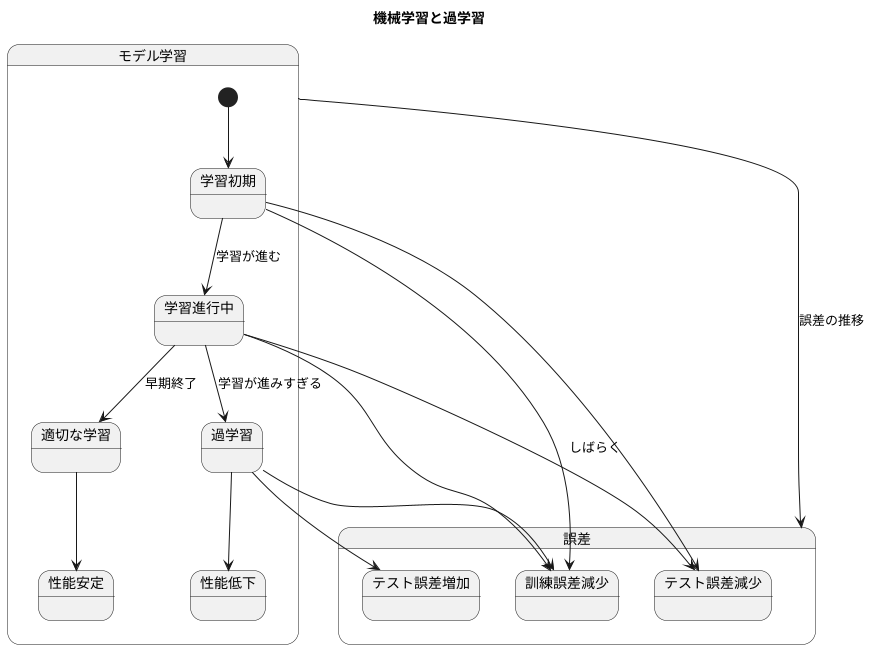
モデルの学習中は、訓練データとテストデータそれぞれに対する誤差を調べます。訓練データに対する誤差を訓練誤差、テストデータに対する誤差をテスト誤差と呼びます。学習の初期段階では、訓練誤差とテスト誤差はどちらも小さくなっていきます。これは、モデルがデータの特徴をうまく捉え始めているためです。しかし、学習が進むにつれて、ある時点から訓練誤差は減り続けるのに、テスト誤差が増え始めることがあります。これが過学習の兆候です。
過学習は、モデルが訓練データに過剰に適応しすぎてしまった状態です。訓練データの細かな特徴や、たまたま存在するノイズまで覚えてしまうため、新しいデータにうまく対応できなくなります。例えるなら、特定の教科書の例題だけを丸暗記した生徒のようなものです。例題は完璧に解けても、少し問題の形式が変わると解けなくなってしまいます。
このテスト誤差の増加を見つけることが、過学習を防ぐ鍵となります。「早期終了」と呼ばれる手法は、このテスト誤差の増加を検知し、学習を適切な時点で止めることで、過学習を抑制します。これにより、未知のデータに対しても高い性能を発揮できるモデルを作ることができます。
早期終了の実装方法

機械学習のモデル訓練において、学習を適切なタイミングで打ち切る「早期終了」は、過学習を防ぎ、モデルの汎化性能を高めるための効果的な手法です。この手法は実装も比較的容易であり、広く活用されています。
まず、モデルの訓練を進めながら、一定の間隔で、訓練データとは別に用意した検証データを用いてモデルの性能を評価します。この検証データに対する評価指標は、モデルが未知のデータにどの程度対応できるかを示す「汎化性能」の目安となります。訓練データに対する性能は上がり続けても、検証データに対する性能が向上しなくなったり、むしろ低下し始めたりした場合は、過学習の兆候と捉えることができます。
早期終了は、この検証データに対する性能の推移に着目します。具体的には、検証データに対する誤差が改善しなくなった時点、もしくはあらかじめ設定した回数連続で改善が見られなかった時点で、モデルの訓練を中断します。
この時、単に訓練を中断するだけでなく、検証データに対する誤差が最も小さかった時点におけるモデルのパラメータを保存しておくことが重要です。訓練を継続すると、訓練データに過度に適合してしまい、汎化性能が低下する可能性があります。そのため、最も汎化性能が高かった時点のパラメータを最終的なモデルとして採用することで、過学習を回避し、未知のデータに対しても精度の高い予測を実現できるモデルを構築することができます。
早期終了は、多くの機械学習ライブラリに標準機能として組み込まれているため、手軽に利用できます。複雑な設定や調整を必要とせず、比較的簡単な手順で実装できるため、実用性の高い過学習対策として広く用いられています。
早期終了は、計算資源の節約にも貢献します。過学習が進むまで訓練を続けるよりも、早期に訓練を打ち切ることで、無駄な計算時間を削減できます。特に、大規模なデータセットや複雑なモデルを用いる場合、この効果は顕著になります。
早期終了の利点

機械学習の訓練において、学習を早めに打ち切る「早期終了」は、モデルの精度向上に役立つだけでなく、様々な利点をもたらします。まず、計算にかかる時間を大幅に短縮できます。訓練データに過剰に適合する「過学習」の状態まで学習を続けるよりも、良い結果が出る時点で学習を止めることで、無駄な計算を省き、計算に使う資源を有効活用できます。
また、モデルの複雑さを調整する手間を省く効果もあります。一般的に、複雑なモデルは過学習しやすい傾向があります。そのため、通常はモデルの複雑さを適切に管理する必要があります。しかし、早期終了を使うことで、ある程度の過学習は自然と抑えられるため、モデルの複雑さに対する調整の手間を減らすことができます。
さらに、学習の様々な設定を調整する手間も簡略化できる場合があります。モデルの学習には、学習の速さや正則化の強さなど、様々な設定項目を調整する必要があります。早期終了はこれらの設定項目による影響をある程度和らげるため、設定の調整の手間を減らすのに役立ちます。
つまり早期終了は、過学習を防ぐだけでなく、計算時間の節約、モデルの複雑さ調整の簡略化、設定項目調整の簡略化といった多くの利点を持つ、機械学習において非常に有用な手法と言えるでしょう。
| 早期終了の利点 | 詳細 |
|---|---|
| 計算時間の短縮 | 過学習に至るまでの無駄な計算を省き、計算資源を有効活用 |
| モデルの複雑さ調整の手間削減 | 過学習が抑えられるため、モデルの複雑さを厳密に調整する必要性を軽減 |
| 学習設定の調整の手間簡略化 | 学習率や正則化など、パラメータ調整の影響を緩和 |
| 過学習の防止 | 訓練データに過剰に適合することを防ぎ、汎化性能を向上 |
早期終了の注意点
機械学習において、学習を早く終わらせる技である早期終了は、計算時間や資源の節約につながる優れた方法です。しかし、いくつかの注意点を守らないと、その利点を十分に活かせないことがあります。
まず、適切な評価指標を選ぶことが重要です。例えば、写真の分類問題では、正しく分類できた割合を示す正解率や、正解率と再現率を組み合わせたF値などが使われます。一方、数値を予測する回帰問題では、予測値と実際の値のずれを測る平均二乗誤差などが使われます。扱う問題の種類によって適切な指標は異なり、指標選びを誤ると、モデルの性能を正しく評価できず、最適なタイミングで学習を止められない可能性があります。
次に、十分な量のテストデータを用意する必要があります。テストデータは、学習に使っていないデータで、学習したモデルが未知のデータに対してどれくらいうまく働くかを評価するために使います。もし、テストデータの量が少なすぎると、評価のばらつきが大きくなり、たまたま良い結果が出た時点で学習を止めてしまうかもしれません。これは、真の性能を反映していないため、新しいデータに対してはうまく働かないモデルになってしまう可能性があります。
最後に、早期終了は万能な解決策ではないことを理解しておく必要があります。早期終了は、学習を途中で止めることで、過学習、つまり学習データに過度に適応しすぎてしまうことを防ぐ効果があります。しかし、過学習を完全に防ぐことは難しく、他の対策と組み合わせることでより効果を発揮します。例えば、モデルの複雑さを抑えるL1正則化やL2正則化、一部の情報を意図的に捨てるドロップアウトといった手法と組み合わせて使うことで、より汎化性能の高い、様々なデータに適用できるモデルを作ることができます。
| 早期終了のメリット | 早期終了の注意点 | 具体的な方法・例 |
|---|---|---|
| 計算時間や資源の節約 | 適切な評価指標を選ぶ |
|
| 十分な量のテストデータを用意する | テストデータの量が少なすぎると、評価のばらつきが大きくなり、真の性能を反映しない可能性がある | |
| 万能な解決策ではない(過学習を完全に防ぐことは難しい) |
他の対策と組み合わせることでより効果を発揮する |