
ε-greedy方策:探索と活用のバランス
AIの初心者
先生、「ε-greedy方策」って、何ですか? 最適な行動をとるんじゃないんですか?

AI専門家
いい質問ですね。確かに、常に最適な行動をとるように思えますが、常に同じ行動ばかりしていると、他に良い行動があるか見逃してしまう可能性があります。そこで、ε-greedy方策では、たまにわざと違う行動をとってみるんです。
AIの初心者
なるほど。たまに違う行動をとることで、より良い行動を見つけようとするんですね。でも、どのくらいの頻度で違う行動をとるんですか?
AI専門家
それはεという値で決めます。εは0から1の間の値で、例えばεが0.1だとすると、10回に1回はランダムに行動を選び、残りの9回は今までで一番良いと思った行動をとります。このランダムに行動するおかげで、新しい良い行動を発見できる可能性が広がるんです。
ε-greedy方策とは。
人工知能の学習方法の一つに、行動の結果として報酬が最大になるように学習していく方法があります。その学習方法の中で、「イプシロン・グリーディー方策」というやり方があります。これは、時々、でたらめに動くことで、より良い行動を見つける可能性を広げる方法です。具体的には、小さな確率(イプシロン)で適当な行動を選び、それ以外のほとんどの場合(1引くイプシロンの確率)では、現時点で一番良いと考えられる行動を選びます。
はじめに
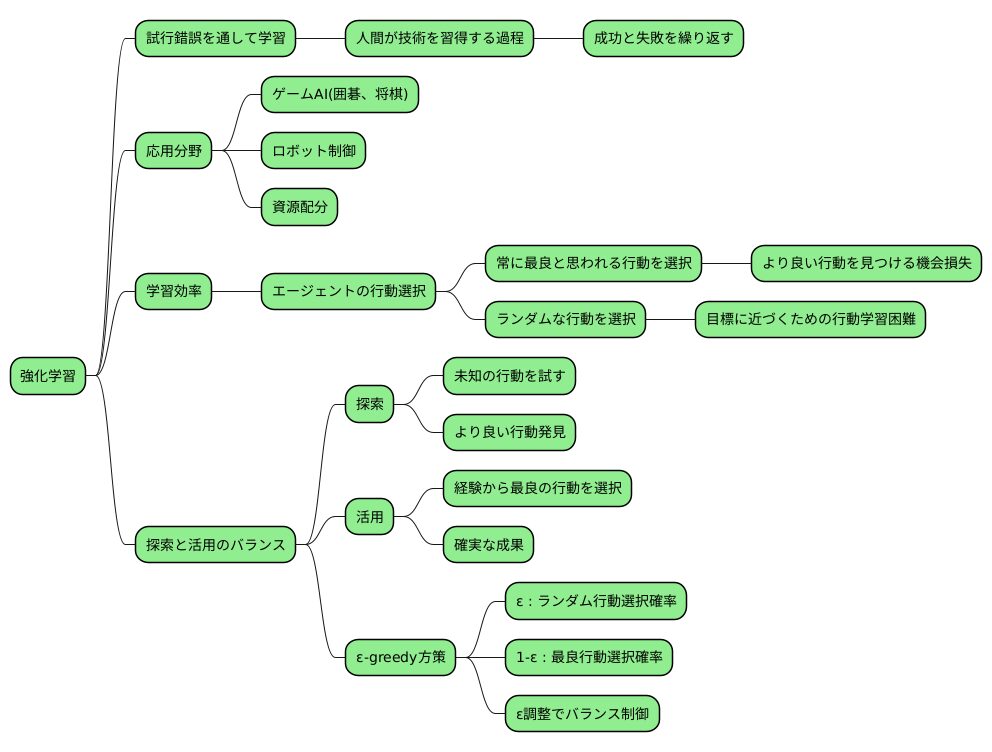
機械学習の中でも、試行錯誤を通して学習する手法を強化学習と言います。この学習方法は、まるで人間が新しい技術を習得する過程に似ています。最初はうまくいかないことばかりでも、何度も挑戦し、成功と失敗を繰り返すことで徐々に上達していく、そのような学習方法です。近年、この強化学習は様々な分野で注目を集めています。例えば、囲碁や将棋などのゲームで人間を凌駕する強さを誇るプログラムや、ロボットの複雑な動きを制御する技術、さらには限られた資源を効率的に配分するシステムなど、幅広い分野で応用が期待されています。
強化学習では、学習を行う主体であるエージェントがどのように行動を選択するかが学習効率を大きく左右します。常に現状で最良と思われる行動だけを選択していては、より良い行動を見つける機会を逃してしまう可能性があります。これは、登山で目の前の小さな丘に登頂しただけで満足し、その先にさらに高い山があることに気づかないようなものです。一方で、やみくもにランダムな行動ばかり選択していては、目標に近づくための効果的な行動を学習することが難しく、いつまでたっても上達しません。これは、地図を持たずにでたらめに歩き回るようなもので、目的地にたどり着くのは困難です。
そこで、探索と活用のバランスが重要になります。探索とは、未知の行動を試すことで、より良い行動を見つける可能性を広げることです。活用とは、これまでの経験から最良と思われる行動を選択し、確実に成果を得ることです。この二つのバランスをうまくとることで、効率的な学習が可能になります。ε-greedy方策は、この探索と活用のバランスを簡単かつ効果的に実現する手法の一つです。この手法では、一定の確率(ε)でランダムな行動を選択することで探索を行い、残りの確率(1-ε)で現状で最良と思われる行動を選択することで活用を行います。このεの値を調整することで、探索と活用のバランスを制御することができ、様々な状況に合わせた学習を実現することができます。
ε-greedy方策とは
「イプシロン・グリーディー方策」とは、機械学習における強化学習で用いられる、行動選択のアルゴリズムの一つです。このアルゴリズムは、未知の環境で学習する際に、既知の最良と思われる行動をとること(活用)と、未知の行動を試すこと(探索)のバランスをうまくとることを目指しています。
このバランス調整の鍵となるのが「イプシロン」と呼ばれる値です。イプシロンは、0から1の間の値として設定されます。この値は、探索を行う確率を表しています。具体的には、ある行動を選択する際に、イプシロンの確率でランダムな行動を選び(探索)、残りの1からイプシロンを引いた確率で、現時点で最も価値が高いと推定される行動を選びます(活用)。
例えば、イプシロンを0.1に設定した場合、10回行動選択を行うと、1回は完全にランダムな行動をとり、残りの9回は現時点で最も良いと思われる行動をとることになります。このように、イプシロンの値を変えることで、探索と活用の割合を調整できます。
イプシロンの値の設定方法には、大きく分けて二つの方法があります。一つは、学習期間を通してイプシロンの値を固定する方法です。もう一つは、学習の初期段階ではイプシロンを大きく設定して探索を重視し、学習が進むにつれて徐々にイプシロンを小さくしていく方法です。
後者の方法では、学習の初期段階では様々な行動を試すことで、より良い行動を見つける可能性を高めます。そして、学習が進むにつれて、すでに得られた知識を活用することで、より効率的に学習を進めることができます。このように、イプシロン・グリーディー方策は、単純でありながらも効果的なアルゴリズムとして、様々な強化学習の場面で活用されています。

探索と活用のジレンマ

機械学習、特に強化学習においては「探索」と「活用」のバランスが重要です。これは、未知の領域を探求する「探索」と、既知の情報に基づいて最良の選択をする「活用」のどちらに重点を置くかという問題です。このバランスをうまくとることが、学習の効率と最終的な成果に大きく影響します。
「探索」とは、未知の行動を試みることで、より良い行動を見つけることです。新しい行動を試すことで、これまで知らなかった、より効果的な方法が見つかる可能性があります。たとえば、新しいお店を開拓したり、行ったことのない道を歩いたりすることで、思わぬ発見があるかもしれません。このように、探索は新たな可能性を広げる役割を担っています。しかし、探索ばかりに集中すると、既にある良い行動を活用する機会を逃し、学習の進みが遅くなる可能性があります。
一方、「活用」とは、現在の知識に基づいて、最も良いと思われる行動を選択し、より多くの報酬を得ることです。たとえば、いつも行くお気に入りの店に行ったり、慣れた道を通ったりすることで、失敗する可能性は低くなります。活用は、これまでの経験を活かして確実な成果を得るために重要です。しかし、活用ばかりに偏ると、現状に満足してしまい、他のより良い選択肢を見逃す可能性があります。つまり、局所的な最適解に陥り、真に最適な行動を見つけられないという状況に陥ってしまいます。
この「探索」と「活用」のジレンマを解決するための方法の一つに、イプシロン-グリーディー方策というものがあります。これは、一定の確率(イプシロン)でランダムな行動(探索)を行い、残りの確率で現状で最良と思われる行動(活用)を行うというシンプルな方法です。このイプシロンの値を調整することで、探索と活用のバランスを細かく調整することができます。 イプシロンの値が大きいほど探索を重視し、小さいほど活用を重視することになります。適切なイプシロン値を設定することで、効率的な学習を実現し、最適な行動を見つけることが期待できます。
| 項目 | 説明 | 例 | メリット | デメリット |
|---|---|---|---|---|
| 探索 | 未知の行動を試みることで、より良い行動を見つける | 新しい店を開拓、行ったことのない道を歩く | 新たな可能性を広げる、より良い行動を発見できる可能性 | 既知の最適行動を活用する機会を逃す、学習の進みが遅くなる可能性 |
| 活用 | 現在の知識に基づいて、最も良いと思われる行動を選択 | いつも行くお気に入りの店に行く、慣れた道を通る | これまでの経験を活かせる、確実な成果 | 現状に満足してしまう、他のより良い選択肢を見逃す可能性(局所最適解に陥る) |
| イプシロン-グリーディー方策 | 一定の確率(イプシロン)でランダムな行動(探索)を行い、残りの確率で現状で最良と思われる行動(活用)を行う | イプシロン=0.1 なら 10%の確率で探索、90%の確率で活用 | 探索と活用のバランスを調整可能 | イプシロン値の設定が難しい |
ε-greedy方策の利点

えпсиろん-探欲方策は、その簡素さと導入の容易さから、強化学習において広く使われています。この方策は、行動選択において、ある小さな確率えпсиろん(ε)で無作為に行動を選び、残りの確率(1-ε)で現在最も良いと思われる行動を選びます。
まず、この方策は非常に計算量が少なく、複雑な計算を必要としません。そのため、限られた計算資源しかない場合や、迅速な意思決定が求められる場合に特に有効です。高度な計算能力を持つ計算機や、多くのメモリを必要としないため、様々な環境で手軽に利用できます。
次に、調整すべき変数がえпсиろん(ε)のみであることも大きな利点です。えпсиろん(ε)の値を調整することで、探索と活用のバランスを簡単に制御できます。えпсиろん(ε)が大きいほど探索を重視し、小さいほど活用を重視します。この単純な仕組みのおかげで、試行錯誤を通して最適なえпсиろん(ε)の値を見つけることが容易になります。複雑なパラメータ調整に時間を費やすことなく、学習を進めることができます。
さらに、えпсиろん-探欲方策は、他の様々な強化学習の手法と組み合わせることができます。例えば、Q学習やSARSAなどの時間的差分学習と組み合わせることで、より効率的な学習を実現できます。また、関数近似などの高度な手法と組み合わせることも可能です。このように、様々な手法と組み合わせることができるため、汎用性が高いと言えるでしょう。
これらの利点から、えпсиろん-探欲方策は強化学習を学ぶ上で最適な出発点となります。複雑な理論や計算に煩わされることなく、強化学習の基本的な概念を理解し、実践することができます。そのため、強化学習の入門として、あるいは実用的な問題解決の手段として、幅広い場面で活用されています。
| 利点 | 説明 |
|---|---|
| 計算量が少ない | 複雑な計算を必要とせず、限られた計算資源しかない場合や、迅速な意思決定が求められる場合に有効。 |
| 調整が容易 | 調整すべき変数はεのみ。εの値を変えることで、探索と活用のバランスを簡単に制御可能。 |
| 汎用性が高い | Q学習やSARSAなどの時間的差分学習、関数近似などの高度な手法と組み合わせることが可能。 |
| 学習の出発点として最適 | 複雑な理論や計算に煩わされることなく、強化学習の基本的な概念を理解し、実践できる。 |
ε-greedy方策の欠点
「ε-greedy方策」とは、機械学習の分野で、ある行動を選択する際に、一定の確率(ε)でランダムな行動を選び、残りの確率(1-ε)で最も良いとされる行動を選ぶ方法です。この方法は分かりやすく、ある程度の効果も期待できるのですが、いくつか弱点も抱えています。
まず、この方法で重要なのが「ε」という値の設定です。この「ε」は、どのくらいの頻度でランダムな行動をとるかを決める数値です。もし、この「ε」の値が大きすぎると、でたらめな行動が多くなり、学習の効率が悪くなってしまいます。例えば、10回行動を選ぶ中で、8回もでたらめな行動をとっていては、なかなか学習が進みません。逆に、「ε」の値が小さすぎると、一番良いとされる行動ばかり選んでしまい、他のより良い行動の可能性を見逃してしまうことがあります。これは、まるで、目の前にある小さな丘が、世界で一番高い山だと勘違いしてしまうようなものです。本当に高い山を見つけるためには、ときには、あえて違う方向を探してみる必要があるのです。
適切な「ε」の値は、扱う問題によって異なってきます。そのため、実際に試行錯誤しながら、最適な値を見つける必要があります。ちょうど、料理の味付けをするように、少しずつ調整していくことが大切です。
さらに、ε-greedy方策では、ランダムな行動を選ぶ際に、すべての行動を同じ確率で選びます。これは、良い行動も悪い行動も同じように選んでしまうということです。もっと賢い探索方法では、より良い結果に繋がりそうな行動を優先的に選ぶことができます。そのため、ε-greedy方策は、他の高度な探索方法と比べると、最適な行動を見つけるのに時間がかかることがあります。まるで、宝探しで、あらゆる場所をくまなく探すようなものです。宝のありそうな場所を重点的に探す方法と比べると、時間がかかってしまうのは当然です。
しかし、ε-greedy方策は、その分かりやすさから、最初の試行錯誤として使う価値のある方法です。複雑な方法を試す前に、まずは簡単な方法で試してみることは、良い考えと言えるでしょう。
| 項目 | 説明 |
|---|---|
| ε-greedy方策 | 一定の確率(ε)でランダムな行動を選び、残りの確率(1-ε)で最も良いとされる行動を選ぶ方法 |
| ε の値の設定 | εの値が大きすぎると学習効率が悪くなり、小さすぎるとより良い行動を見逃す可能性があるため、問題に応じて適切な値を設定する必要がある |
| ランダム行動の選択 | すべての行動を同じ確率で選択するため、良い行動も悪い行動も同じように選んでしまう |
| 探索効率 | 他の高度な探索方法と比べると、最適な行動を見つけるのに時間がかかる |
| 利点 | 分かりやすいので、最初の試行錯誤として使う価値がある |
適用事例
{ε-利欲方策は、様々な場面で活用されている、応用範囲の広い技術です。色々な状況に柔軟に対応できるため、強化学習の課題解決において幅広く使われています。
例えば、テレビゲームを想像してみてください。主人公が敵と遭遇した時、どう行動すべきでしょうか?ε-利欲方策を使うと、主人公は高い確率でこれまで最も効果的だった行動を選びます。しかし、低い確率ではありますが、これまで試したことのない行動を試すこともあります。これにより、より良い行動を見つける可能性が高まります。いつも同じ行動ばかりだと、もっと良い行動を見逃してしまうかもしれないからです。
また、ウェブページに表示する広告を選ぶ際にも、この技術は役立ちます。これまでクリック率が高かった広告を優先的に表示しつつ、たまには新しい広告も表示することで、さらに効果的な広告を見つけ出すことができます。常に同じ広告ばかり表示していては、より良い広告を見つける機会を逃してしまうかもしれません。
さらに、ロボットの制御にも活用できます。ロボットに特定の作業をさせたい場合、ε-利欲方策を用いることで、ロボットはこれまで成功した行動を優先的に行いつつ、時には新しい行動も試すことで、より効率的な作業方法を学習していきます。いつも同じ動きを繰り返すだけでなく、新しい動きを試すことで、より洗練された作業を実現できるのです。
このように、ε-利欲方策は、ゲーム、広告、ロボット制御など、様々な分野で応用できる汎用性の高い技術と言えるでしょう。
| 分野 | ε-利欲方策の活用例 |
|---|---|
| テレビゲーム | 主人公が敵と遭遇した時、最も効果的だった行動を高い確率で選び、低い確率で新しい行動を試す。 |
| ウェブ広告 | クリック率が高かった広告を優先的に表示しつつ、たまには新しい広告も表示する。 |
| ロボット制御 | ロボットがこれまで成功した行動を優先的に行いつつ、時には新しい行動も試すことで、より効率的な作業方法を学習する。 |